Los datos dominicanos: cuando decir “son públicos” no elimina el riesgo
Hace apenas unos días abordábamos en estas páginas una preocupación que comenzaba a tomar forma: bases de datos relacionadas con ciudadanos e instituciones dominicanas apareciendo en foros, canales y mercados digitales utilizados para compartir, vender o intercambiar información.
Entonces la pregunta era fundamentalmente preventiva:
¿qué ocurre cuando nuestros datos terminan en manos de terceros?
Hoy debemos volver sobre el tema.
Pero esta vez existe un nombre —o, más correctamente, un seudónimo— que comienza a repetirse: jarol1488.
El actor se atribuye distintas obtenciones masivas de información en República Dominicana y otros países. Su actividad ya no constituye únicamente conversación dentro de pequeños círculos de ciberseguridad: autoridades extranjeras han abierto investigaciones relacionadas con bases que este mismo usuario asegura poseer, mientras plataformas privadas de inteligencia de amenazas han comenzado a seguir sus publicaciones.
Y ahora aparece una nueva controversia: el Poder Judicial dominicano.
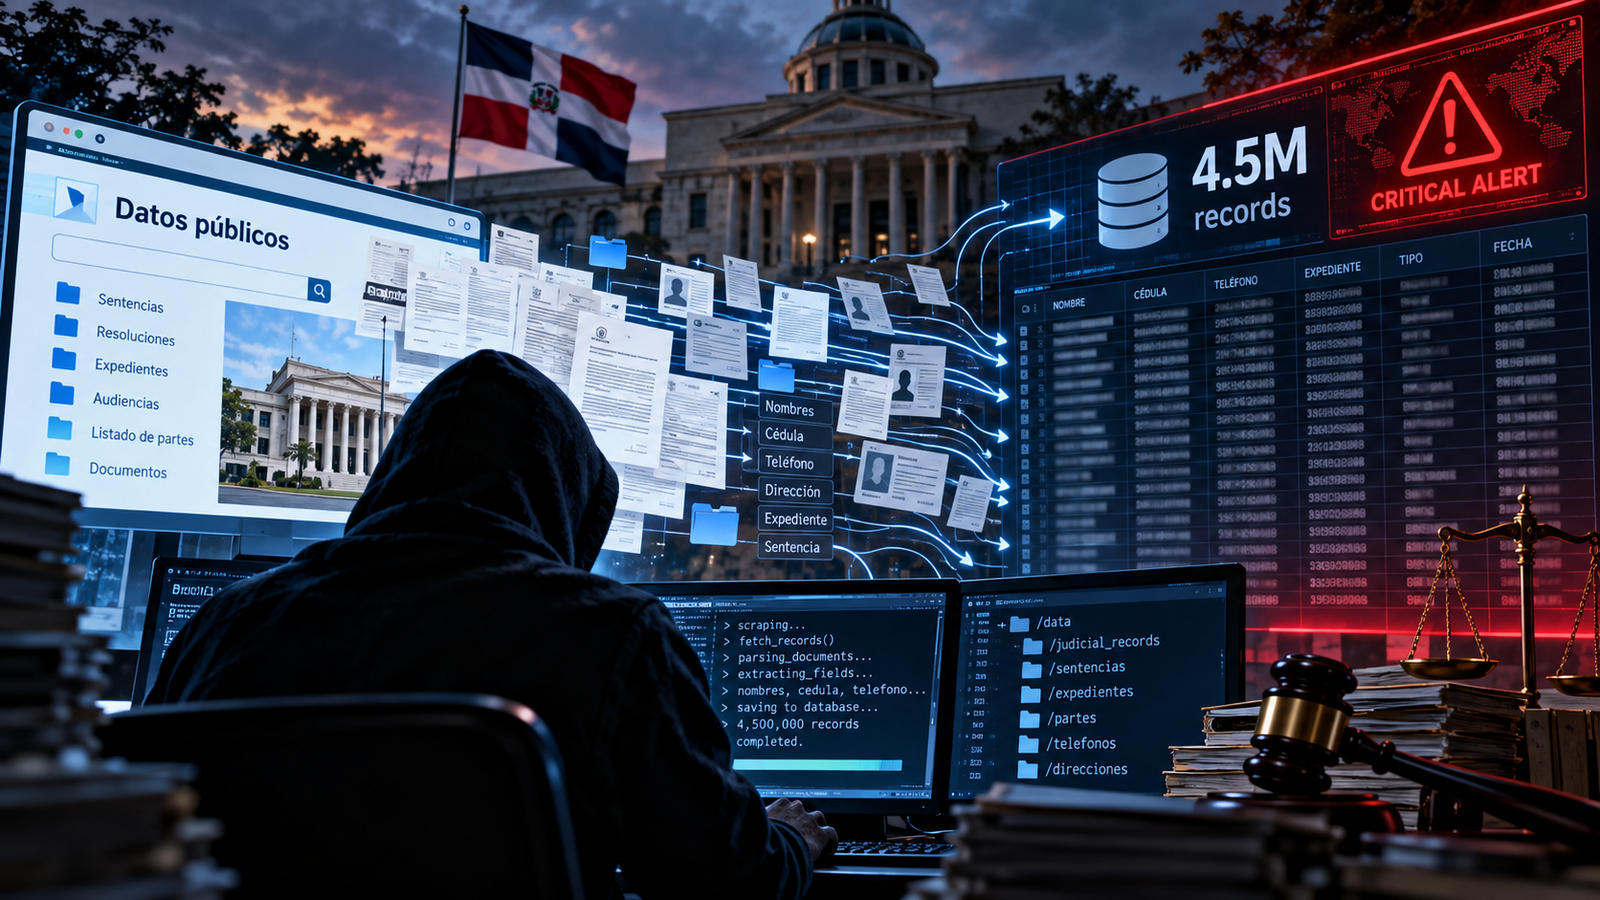
4.5 millones de expedientes o información pública recopilada
La información que circuló inicialmente afirmaba que jarol1488 había comprometido sistemas del Poder Judicial y obtenido aproximadamente 4.5 terabytes de información, correspondientes supuestamente a más de 4.5 millones de expedientes judiciales.
Las publicaciones atribuidas al actor hablaban de sentencias, testimonios, documentos, teléfonos y otros elementos relacionados con procesos judiciales.
La respuesta del Poder Judicial fue categórica en un aspecto: niega haber sido hackeado.
Según la institución, las verificaciones técnicas realizadas no identificaron una extracción no autorizada de información sensible o privada.
Su explicación es que la información señalada corresponde a datos de carácter público disponibles mediante mecanismos institucionales de consulta.
Ese argumento modifica considerablemente la naturaleza técnica del incidente.
Pero no necesariamente elimina el problema.
Hackear y hacer scraping no son lo mismo
Aquí debemos introducir una distinción que resulta fundamental.
Hackear un sistema implica, en términos generales, superar o evadir controles para obtener acceso no autorizado.
Scraping, en cambio, consiste en utilizar programas automatizados para recopilar grandes cantidades de información disponible a través de páginas o servicios web.
Una persona podría consultar manualmente cien expedientes públicos.
Un programa puede intentar consultar millones.
Por tanto, si efectivamente jarol1488 obtuvo la información exclusivamente mediante scraping de contenidos públicamente accesibles, no estaríamos necesariamente ante el mismo escenario técnico que una intrusión a servidores internos.
Pero eso no significa que automáticamente estemos ante una situación inocua.
Ahí está precisamente la discusión que deberíamos estar teniendo.
Público no significa inofensivo
Una sentencia puede ser pública, un expediente puede contener información disponible para consulta.
Un nombre puede aparecer en un proceso.
Un número telefónico puede estar publicado en determinado documento.
Pero existe una diferencia gigantesca entre: consultar individualmente un documento público y construir una base estructurada con millones de documentos y millones de personas.
El peligro aparece cuando información dispersa se convierte en información concentrada.
Un dato aislado puede tener poco valor.
Diez datos sobre una misma persona pueden construir un perfil.
Un millón de perfiles pueden convertirse en una gigantesca herramienta de inteligencia.
Ese es el fenómeno conocido como agregación de datos.
La diferencia entre transparencia y extracción masiva
El Poder Judicial debe garantizar transparencia.
Los ciudadanos deben poder consultar decisiones judiciales.
Los abogados necesitan acceder a jurisprudencia.
Los investigadores necesitan información.
La prensa necesita examinar expedientes cuando legalmente corresponde.
Todo eso forma parte de una sociedad abierta.
Pero construir mecanismos públicos de consulta no necesariamente significa autorizar cualquier forma de extracción industrial de información.
Esta discusión no es exclusivamente dominicana.
En otros países ya existen controversias judiciales sobre empresas que han utilizado scraping para reproducir bases completas de decisiones judiciales. Allí las discusiones giran precisamente alrededor de si el contenido era público, si existían restricciones técnicas y si la automatización superó controles establecidos por la institución.
Por eso la pregunta correcta no es solamente: ¿los documentos eran públicos?
También debemos preguntar: ¿cómo fueron obtenidos, a qué velocidad, mediante qué mecanismos y con qué finalidad?
El Poder Judicial tiene razón en algo importante
Si no existió acceso a servidores internos, no fueron vulneradas credenciales y no se extrajeron archivos privados, llamar automáticamente al incidente “hackeo del Poder Judicial” sería técnicamente incorrecto.
Eso debe reconocerse.
Un titular espectacular puede convertir scraping en intrusión aunque sean fenómenos diferentes.
Y una investigación seria debe respetar esa diferencia.
Pero la otra mitad del problema tampoco debería minimizarse.
Si una persona puede reunir millones de documentos judiciales mediante automatización y posteriormente empaquetarlos, distribuirlos o comercializarlos, existe un riesgo que merece atención institucional independientemente de que el servidor haya sido “hackeado”.
La Ley 172-13 tampoco desaparece porque una fuente sea pública
República Dominicana posee desde 2013 la Ley 172-13 sobre Protección Integral de los Datos Personales.
Su propio objeto incluye la protección de datos personales contenidos en archivos, registros públicos, bases de datos y otros medios de tratamiento, tanto públicos como privados.
Esto introduce una diferencia importante: que un dato esté dentro de un registro público no significa necesariamente que haya perdido toda protección respecto a cualquier tratamiento posterior.
Una cosa es acceso. Otra es tratamiento masivo. Otra es correlación. Otra es comercialización.
Y otra muy distinta es utilizar la información para fraude, suplantación de identidad o ingeniería social.
Ese debate jurídico merece mucho más análisis del que cabe en un simple comunicado de “son datos públicos”.
JAROL1488 no aparece solamente en República Dominicana
Existe otro elemento que convierte el caso en algo más serio.
El seudónimo jarol1488 también aparece vinculado públicamente a una gigantesca base de información atribuida a Costa Rica.
La Agencia de Protección de Datos de los Habitantes de ese país abrió una investigación de oficio en septiembre de 2026 después de recibir un informe técnico de su Dirección Nacional de Ciberseguridad.
El actor afirmaba poseer cientos de millones de registros con información personal y financiera.
Las propias autoridades costarricenses advirtieron que todavía debía determinarse técnicamente el origen de la información y que la publicación de una base en espacios clandestinos no demuestra automáticamente su autenticidad completa.
Ese caso proporciona una lección aplicable inmediatamente a República Dominicana:
la afirmación del supuesto hacker no es evidencia suficiente.
Hay que verificar.
Pero tampoco podemos ignorar al actor
El otro extremo sería considerar irrelevante todo lo que publica porque utiliza un seudónimo.
Eso tampoco sería responsable.
En Costa Rica, una muestra de aproximadamente 10,000 registros atribuidos a la gigantesca base anunciada por jarol1488 fue sometida a revisión oficial y parte de la información resultó auténtica, aunque ello no permitió validar la totalidad del archivo ni determinar inmediatamente su procedencia.
En República Dominicana, el mismo alias había aparecido previamente relacionado con información atribuida al Sistema Policial de Gestión de Denuncias.
VECERT Analyzer reportó publicaciones de jarol1488 sobre ese sistema y clasificó entonces aquellas alegaciones como no confirmadas, señalando que existía material publicado por quien reclamaba el acceso, pero sin verificación independiente suficiente de su procedencia.
También aparece asociado públicamente al episodio de Claro Dominicana, empresa que posteriormente sí reconoció una exposición no autorizada de determinados datos de clientes, aunque no confirmó todos los volúmenes ni afirmaciones difundidas originalmente por el actor.
Es decir: no debemos creerle automáticamente.
Pero tampoco parece prudente ignorarlo automáticamente.
Un ecosistema alrededor de las filtraciones
Durante nuestra investigación encontramos además referencias a espacios de mensajería utilizados para compartir muestras y anuncios atribuidos a jarol1488.
Entre ellos aparece mencionado un grupo bajo un nombre semejante a “leaks/samples jarol1488”, así como usuarios identificados exclusivamente mediante seudónimos.
Entre los alias observados o reportados figuran nombres como “Ciberdelincuencia”, “amateur”, “CryptoDomi” y “Escanor Coder”.
Aquí debemos establecer una precaución periodística indispensable: no hemos podido verificar independientemente la identidad real de esas cuentas ni atribuirles individualmente actividad criminal alguna.
Aparecer dentro de un grupo, utilizar un seudónimo o participar en una conversación no demuestra participación en un delito.
El valor periodístico del hallazgo está en otra parte: muestra la existencia de un ecosistema donde datos, muestras, anuncios y supuestas filtraciones pueden circular rápidamente entre múltiples actores.
Una vez que una base entra allí, controlar quién la copia resulta prácticamente imposible.
El verdadero riesgo no es solamente quién roba
Durante años hemos construido la ciberseguridad alrededor de una pregunta: ¿quién entró a nuestro sistema?
Pero el caso del Poder Judicial plantea otra: ¿qué ocurre cuando alguien no necesita entrar?
Supongamos que el contenido es efectivamente público.
Supongamos incluso que todo fue obtenido utilizando consultas legítimas.
Entonces aparece un problema diferente.
¿Puede una institución detectar que una sola dirección o grupo de direcciones está descargando millones de registros?
¿Existen límites de frecuencia?
¿Existen mecanismos contra automatización abusiva?
¿Las versiones públicas de documentos judiciales eliminan adecuadamente información personal innecesaria?
¿Se registran y analizan patrones anómalos?
¿Puede diferenciarse entre un abogado buscando veinte casos y un bot extrayendo cuatro millones?
Esas preguntas pertenecen también a la ciberseguridad.
El dato público puede convertirse en arma privada
Imaginemos un expediente público que contiene: nombres, direccióne, teléfonos, nombres de familiares, empresa, proceso judicial, informaciones financieras parciales.
Aislado dentro de una sentencia resulta difícil de explotar masivamente.
Ahora imaginemos cuatro millones de registros organizados en columnas.
Entonces podemos buscar: todas las personas de una provincia, todas las personas relacionadas con una empresa, todos los teléfonos asociados a determinados procesos, todos los documentos donde aparezca un apellido, todos los empresarios demandados, todas las personas vinculadas a determinado tipo de caso.
El contenido no cambió.
Cambió su capacidad de explotación.
Ahí radica la diferencia entre información pública e inteligencia estructurada.
Un scraper también puede causar un incidente de seguridad
Existe la percepción de que solamente debemos preocuparnos cuando alguien consigue una contraseña administrativa.
No.
Un sistema público también puede ser explotado mediante automatización.
Un scraper agresivo puede: consumir recursos, crear una copia completa del contenido, detectar patrones internos, reconstruir relaciones, identificar errores de publicación, y combinar información con bases obtenidas de otras fuentes.
El atacante moderno no siempre necesita romper la puerta.
Algunas veces entra por millones de ventanas que estaban abiertas legítimamente.
El peligro de combinar filtraciones
Aquí el caso se conecta directamente con nuestro artículo anterior.
La verdadera amenaza no está necesariamente en una sola base.
Está en la combinación.
Supongamos que alguien tiene: nombre y cédula desde una fuente, teléfono desde otra, dirección desde otra, expedientes judiciales desde otra, fotografía desde una quinta base.
Mediante un identificador común puede construir un perfil considerablemente más completo.
A eso se dedica buena parte de la economía clandestina de datos.
Una filtración aparentemente poco importante puede convertirse en una pieza fundamental cuando se cruza con otras.
4.5 millones no deben medirse solamente en terabytes
La institución puede tener razón al afirmar que no hubo extracción de información privada.
El actor puede tener razón al afirmar que recopiló millones de registros públicos.
Ambas afirmaciones podrían incluso coexistir.
Y ahí está precisamente el problema.
Porque la seguridad de la información moderna ya no puede medirse únicamente mediante: “entraron” o “no entraron”.
También debe preguntarse: ¿qué pudieron recopilar?, ¿qué pudieron correlacionar?, ¿qué pudieron automatizar?, ¿qué pudieron reconstruir?, ¿y qué podrán hacer posteriormente con ello?
¿Qué debería hacer ahora el Poder Judicial?
Primero, publicar una explicación técnica más completa.
No necesita revelar información que facilite ataques.
Pero sí puede aclarar: qué conjuntos de datos fueron recopilados, cuántos registros existen aproximadamente, qué campos contienen, qué parte corresponde realmente a documentación pública, si existieron consultas automatizadas extraordinarias, durante qué período, si fueron activados mecanismos de protección, y si existe información personal que, aunque figure en documentos públicos, debería ser anonimizada o minimizada.
Segundo, realizar una revisión independiente.
En ciberseguridad existe una diferencia importante entre: “nuestros sistemas dicen que no ocurrió” y “una auditoría independiente confirmó que no ocurrió”.
Ambas son útiles.
La segunda proporciona mayor confianza.
Debemos dejar de considerar el scraping un problema menor
El scraping tiene usos legítimos. Investigación académica. Periodismo de datos. Motores de búsqueda. Estudios económicos. Análisis jurídico. Inteligencia de fuentes abiertas.
El problema no es la técnica por sí misma.
El problema es: qué se extrae, a qué escala, bajo qué condiciones, qué controles se evaden, qué derechos están involucrados y qué se hace posteriormente con la información.
Una cuchara y una excavadora pueden mover tierra.
La diferencia está en la escala.
VECERT: alerta no significa sentencia
También conviene entender correctamente el papel de plataformas como VECERT Analyzer.
VECERT monitorea publicaciones de actores y espacios asociados a amenazas informáticas y genera alertas.
Eso es útil como inteligencia temprana.
Pero una alerta no constituye por sí sola una prueba forense de que una institución fue vulnerada.
La propia cobertura de alertas anteriores relacionadas con jarol1488 advertía expresamente que la publicación de muestras o afirmaciones requiere verificación independiente.
Por tanto, si VECERT clasifica un evento como crítico, debemos interpretarlo como:
“esto merece atención inmediata”.
No necesariamente como: “todo lo afirmado por el actor está demostrado”.
Esa diferencia es esencial.
El actor también construye una reputación
Existe además un fenómeno psicológico dentro del mundo del cibercrimen.
El seudónimo tiene valor.
Cuanto más conocido se hace un alias, mayor credibilidad puede tener cuando anuncia una nueva filtración.
Por eso los actores publican muestras.
Presumen cantidades. Enumeran víctimas. Crean canales. Buscan reconocimiento.
La reputación también constituye una moneda dentro de ese ecosistema.
Jarol1488 comienza a aparecer precisamente bajo esa dinámica.
República Dominicana. Costa Rica. Telecomunicaciones. Sistemas públicos. Millones de registros.
Cada nuevo anuncio fortalece la narrativa alrededor del personaje.
Pero una investigación seria debe resistirse a colaborar gratuitamente con esa construcción propagandística.
No necesitamos convertirlo en celebridad.
Necesitamos verificar sus afirmaciones.
El problema no es JAROL1488
Esta quizás sea la conclusión más importante.
Hoy se llama jarol1488.
Mañana tendrá otro nombre.
Puede ser otro individuo,otro grupo, otro país.
El verdadero problema es que tenemos una sociedad donde cantidades gigantescas de información personal pueden ser: consultadas, copiadas, correlacionadas, reempacadas y redistribuidas con una facilidad que nuestras instituciones todavía parecen no haber incorporado completamente a su modelo de riesgo.
Por eso concentrarnos exclusivamente en atrapar al supuesto hacker sería insuficiente.
Debemos preguntarnos por qué puede obtener tanto.
“Son datos públicos” no puede ser el final de la conversación
Puede ser una explicación técnicamente correcta.
Pero no una política de ciberseguridad.
Si cuatro millones de registros pueden reunirse automatizadamente, la institución debe analizar el riesgo.
Si contienen datos personales, debe evaluarse la necesidad de cada campo.
Si los documentos pueden indexarse masivamente, debe estudiarse qué información debe anonimizarse.
Si existen mecanismos automatizados de consulta, deben monitorearse.
Y si un actor está construyendo una gigantesca base sobre ciudadanos dominicanos utilizando información dispersa entre múltiples organismos, entonces estamos ante un asunto que trasciende al Poder Judicial.
Estamos frente a un problema nacional de gobernanza de datos.
La próxima filtración quizá no necesite hackeo
Esa podría ser la mayor lección de este episodio.
Durante años imaginamos al hacker atravesando firewalls, rompiendo contraseñas y penetrando servidores secretos.
El atacante moderno puede hacer algo mucho más sencillo.
Recoger aquello que nosotros mismos publicamos.
Automatizarlo. Ordenarlo. Cruzar sus identificadores. Agregar datos obtenidos de otras filtraciones. Y convertir información aparentemente inocente en un expediente digital sobre millones de ciudadanos.
Por eso la pregunta que deben hacerse ahora las instituciones dominicanas no es únicamente: ¿nos hackearon?
Hay otra igualmente importante: ¿qué puede construir alguien con todos los datos que nosotros mismos dejamos disponibles?
Porque en el mundo digital existe una diferencia enorme entre que un dato sea público y que millones de datos públicos sean convertidos en una sola base.
Y esa diferencia puede ser exactamente la distancia entre transparencia e inteligencia criminal.
